详细介绍
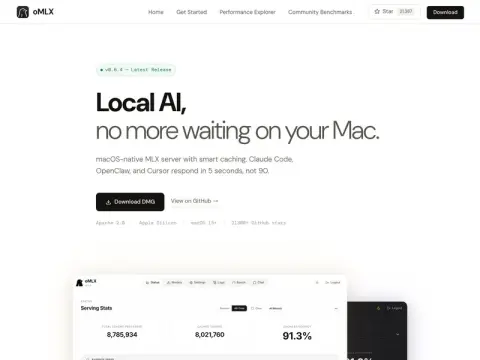
oMLX 是一个 macOS 原生的推理服务器,基于 MLX,专门为在 Mac 上跑本地模型做优化。
它针对的痛点很明确:编码 Agent 一个会话里会反复让 KV 缓存失效,每次都要从头重算 prompt,等待时间能到 30 到 90 秒。oMLX 的做法是把缓存块以 safetensors 格式持久化到 SSD,热块留在内存、冷块按 LRU 落盘,之前见过的前缀可以在毫秒级从磁盘恢复,跨请求甚至跨服务器重启都有效。官方给的结果是第二轮之后首字延迟压到 5 秒以内。
API 兼容 OpenAI 和 Anthropic 两套格式,Claude Code、OpenClaw、Cursor 都能直接指过去。项目采用 Apache 2.0 协议,需要 Apple Silicon 和 macOS 15 及以上。
适合手里有大内存 Mac、想把编码 Agent 的推理挪到本地的开发者。
相关推荐
LeadsNavi
LeadsNavi识别网站访问者,为B2B潜在客户生成提供公司和联系信息。
Adadot for Developers
Adadot使用人工智能通过数据驱动的洞察来提升开发者的表现和福祉。
Wudpecker
结合分析和反馈的产品智能平台,为 B2B SaaS 客户成功服务。
HypeAuditor
以数据驱动的网红营销平台,用于查找、分析和管理网红活动。
superQuery – BigQuery AI optimization engine
AI驱动的BigQuery开发环境,用于增强数据分析。
Metabase – ChatGPT
Metabase扩展,利用ChatGPT进行查询辅助。